
Un modelo predictivo de deserción de clientes es un modelo estadístico que usa el historial de compras, pagos, reclamos e interacciones para asignar a cada cliente la probabilidad de irse en un plazo definido. Sirve para actuar antes de la baja, empezando por los clientes de mayor valor y mayor riesgo.
Si quieres saber si tus datos ya alcanzan para anticipar la deserción de tus clientes, puedes agendar un diagnóstico con ClaryON y revisarlo con un consultor senior.
Perder clientes casi siempre se descubre tarde: cuando la cuenta ya se cerró, la póliza no se renovó o el crédito se canceló. A partir de ese momento solo queda intentar recuperarlo. Aquí explicamos cómo funciona un modelo de deserción, qué datos necesita, cómo se construye, cómo se valida y, sobre todo, cómo se convierte en acciones de retención.
¿Qué es la deserción de clientes y cómo se mide?
La deserción de clientes, también llamada churn o tasa de abandono, es la proporción de clientes que dejan de comprar o cancelan el servicio en un periodo. Se calcula dividiendo los clientes perdidos en el periodo entre los clientes activos al comienzo del mismo.
Medirla bien exige una definición clara de baja. En una relación con contrato, como un seguro, un crédito o una suscripción, la baja es una fecha concreta: la cancelación o la no renovación. En una relación sin contrato, como una tienda o un distribuidor, hay que fijar una regla, por ejemplo “cliente que no compra en 90 días”. Esa regla cambia el resultado del modelo, así que se acuerda con el negocio antes de tocar un dato.
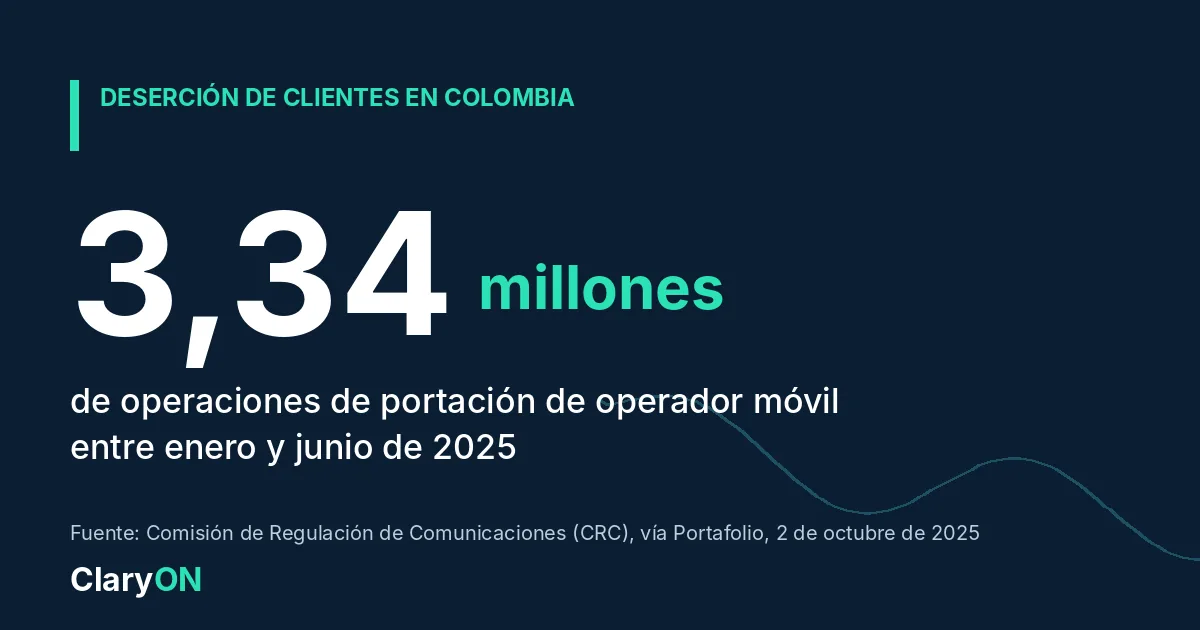
Para dimensionar el fenómeno, la CRC reportó 3,34 millones de operaciones de portación de operador móvil en el primer semestre de 2025 en Colombia (Portafolio, 2 de octubre de 2025). Son operaciones en las que un usuario cambió de proveedor conservando su número. Muestra lo fácil que es hoy cambiar de empresa cuando la oferta es parecida.
¿Qué es un modelo predictivo de deserción?
Es un modelo que aprende de los clientes que ya se fueron para estimar quién se parece a ellos hoy. Toma el comportamiento de cada cliente en una ventana de observación, por ejemplo los últimos seis meses, y calcula la probabilidad de que se vaya en la ventana siguiente, por ejemplo los próximos tres meses.
El resultado es un puntaje de riesgo por cliente. Dentro de la analítica de datos para empresas, este es el paso de la analítica descriptiva (qué pasó) a la predictiva (qué va a pasar) y de ahí a la prescriptiva (qué hacer con cada cliente).
¿Qué técnicas se usan para predecir la deserción?
Las más comunes son la regresión logística, los árboles de decisión y los modelos de conjunto como los bosques aleatorios y el gradient boosting. La regresión logística es fácil de explicar a un comité. Los modelos de conjunto suelen capturar relaciones más complejas. En la práctica se comparan varios con los mismos datos y se elige el que mejor equilibre precisión y facilidad de explicación.
La misma lógica de puntaje de riesgo se aplica antes de otorgar un crédito; si quieres ver qué datos usa y cómo se construye un modelo de originación, lo explicamos en nuestro artículo sobre scoring crediticio.
¿Qué datos necesitas para predecir la deserción de clientes?
Menos de lo que parece, pero ordenados. Estas son las familias de datos que más aportan:
| Tipo de dato | Ejemplos | Señal que aporta |
|---|---|---|
| Transacciones | Compras, pagos, renovaciones, montos y fechas | Frecuencia, recencia y caída del gasto |
| Servicio | Reclamos, tiempos de respuesta, casos abiertos | Insatisfacción antes de la baja |
| Cliente | Antigüedad, producto, canal, sector, ciudad | Perfil y etapa de la relación |
| Interacción | Visitas al portal, aperturas de correos, contactos con el asesor | Nivel de compromiso con la marca |
| Cartera y pagos | Mora, atrasos, cambios de forma de pago | Tensión financiera y riesgo de cancelación |
La condición indispensable es la consistencia: un identificador único por cliente en todos los sistemas, fechas con el mismo formato y una sola definición de cada indicador. Sin eso, el modelo aprende ruido.
¿Cómo se construye un modelo de deserción de clientes paso a paso?
- Define la baja y el horizonte. Qué cuenta como deserción y en cuánto tiempo se quiere anticipar.
- Arma la base histórica. Una fila por cliente y corte de fecha, con sus variables hasta ese corte y la marca de si se fue después.
- Crea variables útiles. Cambio del gasto frente al trimestre anterior, días desde el último contacto, número de reclamos recientes.
- Entrena y compara modelos. Con una parte de los datos para aprender y otra, separada en el tiempo, para probar.
- Valida con datos que el modelo no vio. Se simula el pasado: qué habría predicho el modelo hace tres meses y qué ocurrió realmente.
- Define el umbral de acción. A partir de qué puntaje se interviene, según la capacidad del equipo y el costo de cada contacto.
- Ponlo a trabajar y mídelo. El puntaje se actualiza con frecuencia fija y se compara contra un grupo de control.
¿Tienes los datos pero no sabes por dónde empezar? En 30 minutos revisamos qué información tienes y qué decisión de retención conviene anticipar primero.
¿Cómo saber si un modelo predictivo de deserción de clientes funciona?
Un modelo sirve cuando ayuda a decidir mejor que la intuición del equipo. Tres revisiones lo muestran:
- Capacidad de ordenar. El área bajo la curva ROC mide si los clientes que se fueron recibieron puntajes más altos que los que se quedaron. Un valor de 0,5 equivale al azar y 1 a un orden perfecto.
- Concentración del riesgo. Se divide la cartera en diez grupos por puntaje y se compara la tasa real de deserción de cada uno. Si el grupo de mayor riesgo se va muy por encima del promedio, el modelo concentra bien el esfuerzo.
- Calibración. Si el modelo dice 30% de probabilidad, aproximadamente 30 de cada 100 de esos clientes deben irse. Sin calibración, las cifras de ahorro proyectadas no son confiables.
Además se vigila el desempeño en el tiempo. Los clientes, los precios y la competencia cambian, y un modelo entrenado con el comportamiento de hace dos años pierde precisión si nadie lo recalibra.
¿Cómo convertir el puntaje de riesgo en retención?
El puntaje por sí solo no retiene a nadie. Genera valor cuando cada nivel de riesgo dispara una acción con dueño y fecha:
Si esa acción la ejecuta un agente de IA, por ejemplo un mensaje de retención, define antes qué puede hacer, qué queda registrado y cuándo pasa el caso a una persona; lo desarrollamos en agentes de IA en empresas.
- Riesgo alto y cliente de alto valor: llamada del asesor o gerente de cuenta en los próximos días, con una oferta preparada.
- Riesgo alto y valor medio: contacto automatizado por correo o WhatsApp con un beneficio puntual.
- Riesgo medio: seguimiento programado y revisión de la causa más probable, como un reclamo sin resolver.
- Riesgo bajo: operación normal, sin gastar presupuesto de retención.
Priorizar por riesgo multiplicado por valor del cliente evita lo más caro: ofrecer descuentos a quienes igual se iban a quedar. Y para saber si la acción funciona, una parte de los clientes en riesgo se deja sin intervenir y se compara su resultado contra los contactados.
Y para que el equipo comercial sepa qué decir cuando llame a esos clientes en riesgo, vale la pena conocer cómo funciona el entrenamiento en ventas con IA de PitchMonster.
¿Dónde se aplica en empresas colombianas?
La lógica sirve en sectores donde la relación con el cliente se renueva o se puede cancelar. Tres ejemplos ilustrativos, sin cifras:
- Seguros: un corredor o aseguradora anticipa qué pólizas no se renovarán según reclamos recientes, cambios de prima y contactos con el asesor, y prepara la renovación con anticipación.
- Crédito y cartera: una entidad identifica a los clientes con alta probabilidad de cancelar o prepagar el crédito y a los que muestran señales de atraso, y ajusta su contacto en cada caso.
- Servicios y suscripciones: una empresa de telecomunicaciones, salud prepagada o educación detecta la caída de uso que antecede a la baja y reacciona antes del siguiente ciclo de facturación.
En todos los casos el punto de partida es el mismo: una decisión concreta de retención y datos confiables para respaldarla. Si la base de información aún está dispersa, conviene resolver primero la transformación digital de la empresa en sus procesos y sistemas.
¿Cuáles son los errores más comunes al predecir la deserción?
- Definir mal la baja. Un modelo que predice algo distinto de lo que le importa al negocio no se usa.
- Usar datos del futuro. Si una variable solo se conoce después de la baja, el modelo parece excelente en la prueba y falla en la vida real.
- Quedarse en el puntaje. Sin una acción asignada, la lista de riesgo termina en una carpeta.
- No medir contra un grupo de control. Sin comparación, no se sabe si la retención mejoró por el modelo o por otra causa.
- Entrenar una vez y olvidarlo. El comportamiento de los clientes cambia y el modelo necesita seguimiento.
¿Cómo lo abordamos en ClaryON?
En la Línea 04, analítica de datos y modelos predictivos, partimos de la decisión de retención y de los datos que la empresa ya tiene. Construimos el modelo, lo validamos con datos de periodos anteriores y lo dejamos conectado a un tablero y a una acción para cada nivel de riesgo. En los proyectos de esta línea, la meta de referencia es de hasta 15% más fidelización, una cifra que se fija contra la línea base de cada empresa y no constituye una garantía. Puedes conocer la línea completa en analítica de datos y modelos predictivos.
Sigue leyendo
- Analítica de datos para empresas: de reportes a decisiones
- Aplicaciones de la inteligencia artificial en empresas colombianas que sí miden retorno
- Línea 04: Analítica de datos y modelos predictivos
Preguntas frecuentes
¿Qué es un modelo predictivo de deserción de clientes?
Es un modelo estadístico que estima la probabilidad de que cada cliente se vaya en un plazo definido, con base en su comportamiento histórico. Permite actuar antes de la baja.
¿Qué datos se necesitan para predecir la deserción?
Transacciones, reclamos y servicio, datos del cliente, interacciones y pagos, con un identificador único y fechas consistentes. Para ver cómo ordenar esa base, revisa la guía de analítica de datos para empresas.
¿Cuánto tiempo toma construir un modelo de deserción?
Depende de la calidad de los datos. Con fuentes accesibles y una definición clara de baja, un primer modelo puede estar listo en pocas semanas. La parte más lenta suele ser ordenar los datos, no entrenar el modelo.
¿Cómo se mide el éxito de un modelo de deserción?
Con métricas técnicas, como el área bajo la curva ROC y la concentración del riesgo por grupos, y con un resultado de negocio: la diferencia de retención entre clientes contactados y un grupo de control.
¿Una empresa mediana puede usar modelos predictivos?
Sí. Lo que se necesita es historia suficiente de clientes que ya se fueron, datos consistentes y una acción de retención clara. No se requiere una gran infraestructura para el primer modelo.
Anticipa la deserción antes de que se convierta en baja. Te ayudamos a construir el modelo, validarlo y conectarlo a las acciones que tu equipo sí va a ejecutar.
William Bareño, actuario de ClaryON. Magíster en Ciencias Actuariales, con experiencia en riesgo crediticio, tarificación y ciencia de datos.